电商物流指南

如何审计上线后的自动选承运商规则

上线自动选承运商的那天通常很顺利:规则配好、标签自动打印、成本看板上一片绿色。几周或几个月之后,问题开始冒出来:财务拿来的账单和报价对不上,客服开始转来客户投诉,仓库里手动改 carrier 的操作越来越多。这时候团队最需要回答一个问题:系统到底为什么选这个 carrier?

编辑插画:一位运营人员坐在仓库办公室的电脑前,盯着屏幕上的一组数据图表,桌面上散落着快递面单和运费账单,白底编辑插画风,橙色调点缀,笔触带手作感,人物微侧身,画面留白充分
自动选承运商上线只是开始,真正的成本真相在结算账单里

问题:系统在选,但没人能解释为什么

这个问题背后是四个具体的疑问。系统选择某个 carrier,依据是什么?它是否真的比候选列表里其他可执行方案更好?所谓节省,来自真实结算成本,还是只是报价页面上的数字?因为追求低价,delivery performance 是否在悄悄变差?如果团队连这四个问题都答不上来,那自动化省下的只是操作时间,代价是失去对决策的控制。

还有两个容易被忽视的信号。第一,manual override 越来越多,它是规则失效的报警,还是正常业务例外的自然分布?第二,规则上线时的 rates、carrier coverage 和 parcel profile,到今天已经变了多少?费率在调、承运商在增减线路、包裹的平均重量和尺寸在漂移,规则却可能一次都没动过。仅 UPS 和 FedEx 两家,2026 年基础费率就上调了约 5-7%,叠加附加费后总成本增幅达到 10-18%[^4]。

审计的目的不是推翻自动化,而是让自动化重新变得可解释。要系统地压低运费成本,可以先把我们的《如何降低运费成本》指南作为整体框架。
为什么传统指标证明不了什么

过去衡量选 carrier 自动化的成功,标准通常是这样几条:少开几个 carrier portal,标签打印得更快,每次选择都显示价格最低的选项,人工操作更少。

这些指标衡量的都是便利,不是决策正确。一个规则可以同时满足以上所有标准,却仍然每天选错。报价页面的低价不代表结算成本低:后续的 DIM 重量调整[^1]、residential 附加费[^2]、fuel surcharge[^3] 都会改变真实成本。低价 service 还可能破坏对客户的承诺,客户按 checkout 的 promise 预期收货,晚到一天就是一次差评或一次退款。

更隐蔽的是被放大的错误。carrier coverage 和 performance 会变化,这些变化不会自己走进规则里。而一旦 dimensions 数据错了,或者规则优先级配错了,自动化不会停下来纠正,它会把同一个错误成千上万次地重复执行。人工时代一个操作员的失误影响一单,自动化时代一个配置失误影响所有单。上线前的规则设计应该避免这些坑,见姊妹篇《如何在不断送时效承诺的前提下自动化选承运商》。

新框架:Carrier Decision Quality Loop

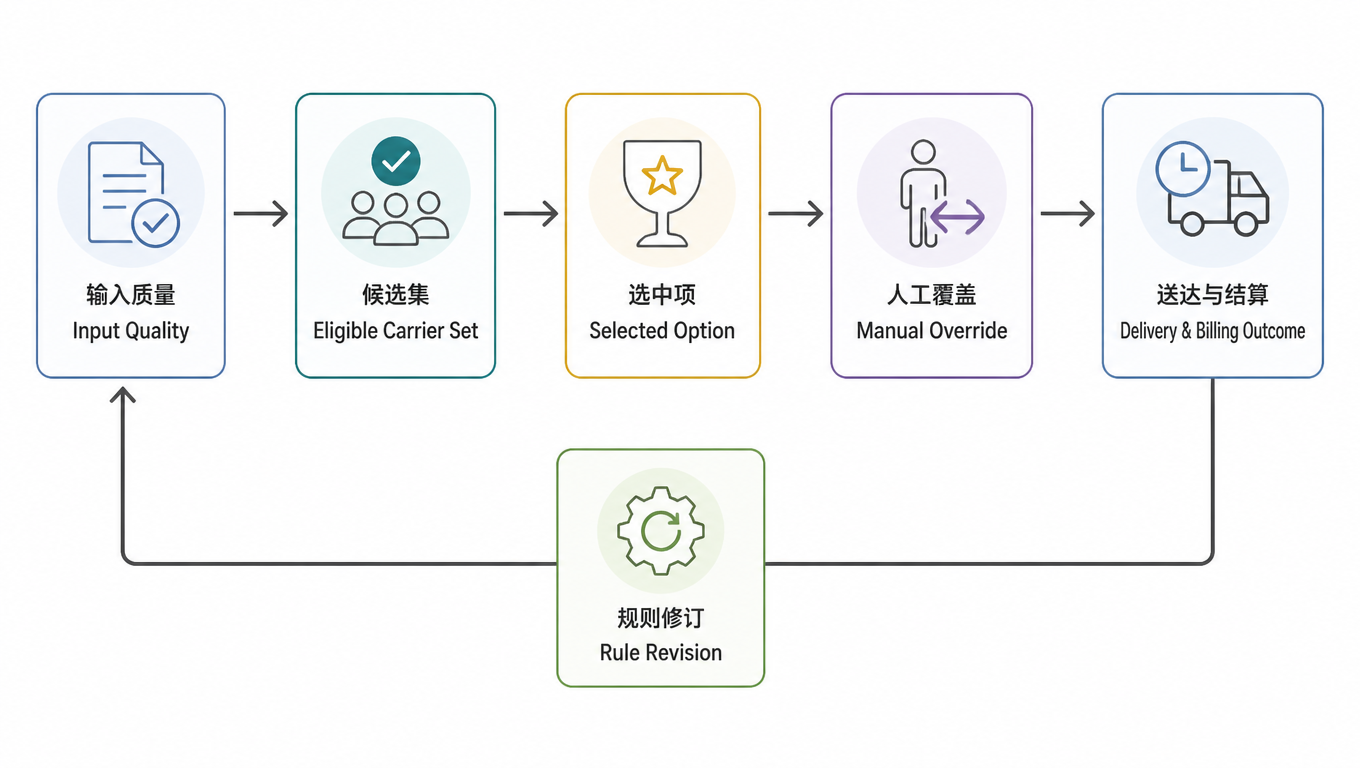
要跳出「只看结果指标」的陷阱,需要换一个框架。建议建立 Carrier Decision Quality Loop,一个覆盖决策全链路的闭环:Input Quality → Eligible Carrier Set → Selected Option → Manual Override → Delivery & Billing Outcome → Rule Revision。

闭环流程图:输入质量 → 候选集 → 选中项 → 人工覆盖 → 送达与结算 → 规则修订 → 回到输入质量
Carrier Decision Quality Loop:从输入到结算再到规则修订的闭环

每一环回答一个具体问题:

  • Input Quality:输入数据(重量、尺寸、地址、服务资格)可信吗?
  • Eligible Carrier Set:候选集完整吗,每个选项真的可执行吗?
  • Selected Option:选中项依据什么规则选出来的,选择理由能解释吗?
  • Manual Override:为什么被人工改掉,改成了什么?
  • Delivery & Billing Outcome:实际送达和实际扣费,与选择时的预期差多少?
  • Rule Revision:把前五环的发现改回规则里,然后重新进循环。

这个框架的重点不是「哪个 carrier 最好」,而是每一个决策能不能被解释、被验证、被改进。下次再有人问「规则现在还好用吗」,你不需要拍脑袋,只需要沿着循环把每一环的证据拿出来。

拆解关键变量

审计不能停留在框架层面,最终要落到具体变量上。按职责把变量分成五组,逐组核对,比散点式检查可靠得多。

第一组是资格与数据:origin、destination ZIP、zone 和 serviceability 决定了一个 carrier 能不能接这一单;actual weight、dimensions 和 billable weight 决定了按什么计费;HAZMAT、PO Box、高价值订单这类资格限制,决定了很多订单根本不该进候选池。数据组是整条链路的入口,这里错了,后面所有环节都在错误的基础上运行。第二组是承诺与执行:checkout 上展示给客户的 delivery promise,和仓库的 cutoff 时间是否一致?如果 promise 承诺 3 天,而系统选了一个 5 天的 service,这就是在制造客户投诉。

第三组是费率与结算:base rate、可预见附加费和最终结算成本要分开看;报价页面和结算账单之间的差距,正是前面说的「节省幻觉」的来源,报价与最终扣费的完整拆解见《报价 vs 最终扣费》。第四组是性能与结果:carrier performance 要按 lane、service、parcel profile 三个维度拆开看,一个 carrier 整体表现好,不代表它在你的主 lane 上表现好;on-time、claim、RTS、refund、reship 是结果侧的硬指标,怎么给承运商打分见《承运商绩效记分卡》。第五组是规则与异常:rule priority、rule conflict、fallback behavior 决定规则按什么顺序、在什么情况下生效;API timeout、no-rate response、label failure 是系统层面的异常;manual override rate 和 override reason 是规则的体检报告;3PL 还要额外核对 client-specific carrier policy 有没有被规则正确覆盖。

变量组 要核对的字段 典型的异常信号
资格与数据origin/destination ZIP、zone、serviceability;actual weight、dimensions、billable weight;HAZMAT、PO Box、高价值订单限制同一 ZIP 反复出现 no-rate;DIM 与实际体积不符
承诺与执行checkout delivery promise、warehouse cutoffpromise 与所选 service 时效不一致
费率与结算base rate、可预见附加费、最终结算成本报价与账单的偏差集中在某几类附加费
性能与结果lane/service/parcel profile 维度下的 on-time、claim、RTS、refund、reship某条 lane 的 on-time 长期低于整体
规则与异常rule priority、rule conflict、fallback;API timeout、no-rate、label failure;override rate/reason;client-specific policyoverride 集中在同一类订单;fallback 频繁触发

为什么员工在绕过你的自动选承运商规则?

自动化上线几个月之后,仓库里会出现一个新现象:员工手动改选承运商的动作越来越频繁。管理者面对这个现象通常有两种反应,而两种都不对。一种是把改选当成操作纪律问题,要求大家「按系统来」;另一种是看到改选变多就断定规则坏了,马上动手改规则。真正要回答的问题更小也更具体:这一次改选,是系统出错了,还是员工掌握了系统里没有的信息?

「人工操作减少」不能独立证明选得对。一套规则可以让人工操作降到接近零,同时每天选错。反过来,总 override rate 也有它的问题:它把两类完全不同的东西混在一起,必要的业务例外,和真正失效的规则。把所有改选都当成失败,会误伤必要的人工判断,也会让一线不敢在明显不对的时候停下来;把所有改选都当成「员工更懂」,又会掩盖另一类损失,比如有人出于习惯选了自己熟悉的服务,每单多付一点,而没有任何记录能证明或推翻这个判断。

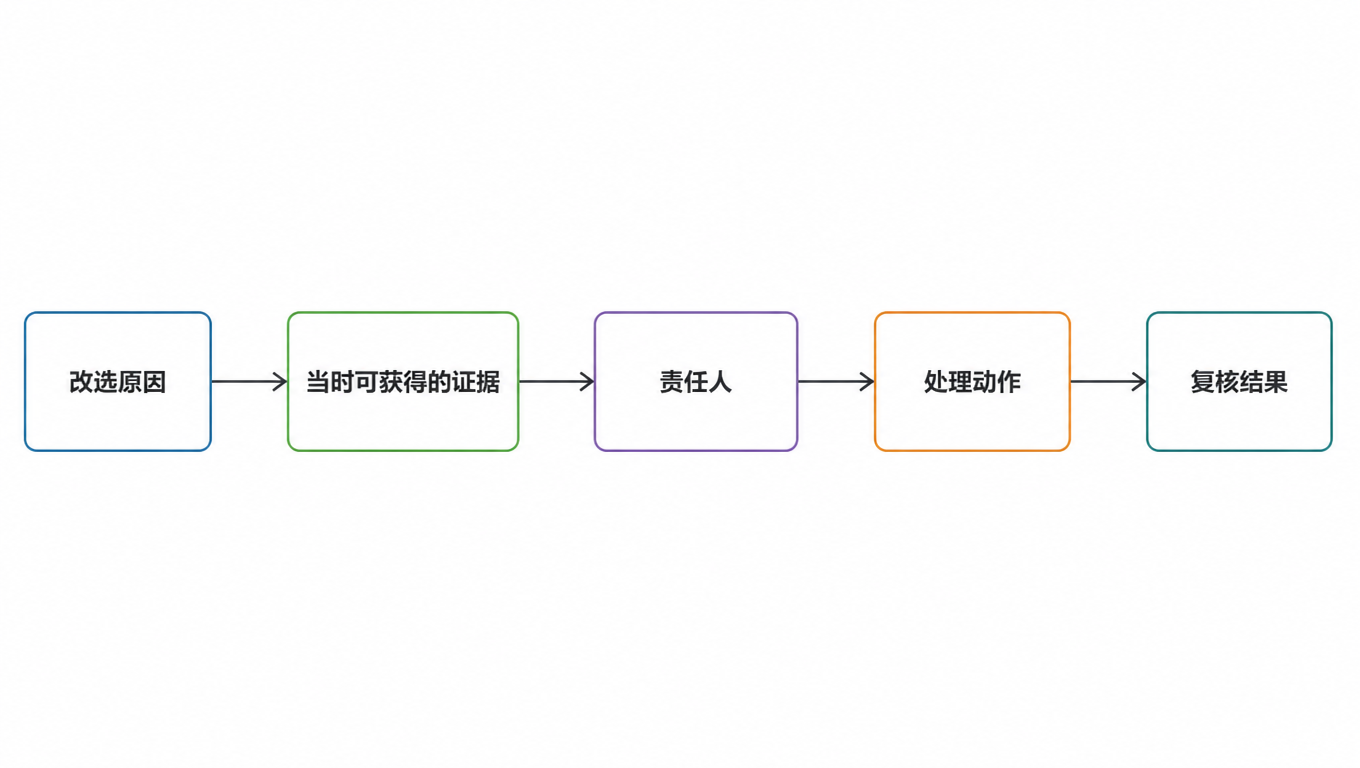
要判断一次改选属于哪一类,在现有的审计闭环里补一条改选复核链就够了:改选原因 → 当时可获得的证据 → 责任人 → 处理动作 → 复核结果。纪律在于每一环记录的是那时候掌握的东西,而不是事后补写的理由。然后给每次改选归到一个类别:有效例外、输入错误、规则错误、执行条件变化。归类的依据必须是改选发生时可获得的证据,不能用后来的结果倒推,否则你只是在为已经持有的结论找论据。

改选复核链流程图:改选原因 → 当时可获得的证据 → 责任人 → 处理动作 → 复核结果
改选复核链:把每一次人工改选变成一条可复核的记录

要记录的字段跟着这条链走:原选服务、改选服务、规则版本、原因码、订单与包裹属性、客户限制、当时的截单与提货条件,以及报价费用和最终实际费用。比字段更容易出错的是分母。如果分子是「被人工改选的 shipment」,分母就必须是「进入自动选服务流程的 shipment」,既不是订单数,也不是包裹数。订单和包裹不能共用同一个比率,一单多件会把分母抬高、把比率压低。分母定清楚之后,再按客户、仓库和原因码分组看,才分得出问题是全局的还是局部的。

拿到分类和分组之后,按下面这张表决定动作。

发现 推荐动作
重量、尺寸或地址输入错误修正数据来源,再重跑规则
客户明确限制某承运商把经确认的客户要求纳入资格过滤
原选服务已错过交接窗口核查还可执行的备选;没有合适选项则人工处理
多条规则冲突复核优先级顺序,用受影响的样本测试
只因个人习惯改选先比较当时可执行的选项和后续结果,再决定是否调整
缺少改选原因或候选记录先补记录,不要据此宣称规则有问题

还有一条边界很容易被越过去:对没有实际承运的备选方案,只能做估算或试点验证,不能把它的费用和交付表现写成已经发生的结果。在说「当时换成 B 就能省下来」之前,先问这个数字来自哪里,是当时的报价、是历史上同类 lane 的实际结算,还是你的直觉。报价是报价,估算是估算,只有真正承运过并送达的单,才构成可以引用的结果。

30 天审计流程:一套 Decision Framework

把上面的变量装进一个可执行的流程。推荐的节奏是 30 天一个周期,因为多数 carrier 的 billing cycle 和 settlement 周期都在这个量级[^5],30 天足够把「报价、结算、送达」三个结果对齐。

  1. 选一个有代表性的 parcel sample,而不是只看平均单。平均单会抹平异常,按 lane、service、重量段分层抽样,保证每个重要组合都有样本。
  2. 保存每单的候选 carrier、选择结果和选择原因。没有日志就没有审计,这一步在规则层面就要打开 decision log。
  3. 检查候选集是否完整,且所有选项都真正可执行。被排除的 carrier 是配置排掉的,还是真的服务不了?
  4. 对比 selected option、next-best option、最终扣费和实际送达结果。四个数字并排看,差距就是优化的方向。
  5. 给 manual override 建立标准 reason codes。没有 reason code 的 override 只是噪音,有了分类才能看出规则在哪类单上系统性失效。
  6. 找出规则冲突、数据错误和异常集中的 lane 或 package。异常从来不是均匀分布的,先定位再动手。
  7. 每次只调整一类规则,做小比例 controlled rollout。比如先放 5% 的单量验证,观察结算和时效再放大。
  8. 设定 rollback 条件和月度或季度复审机制。规则改完不等于结束,要定义什么信号触发回滚,并固定下一次复审的时间。

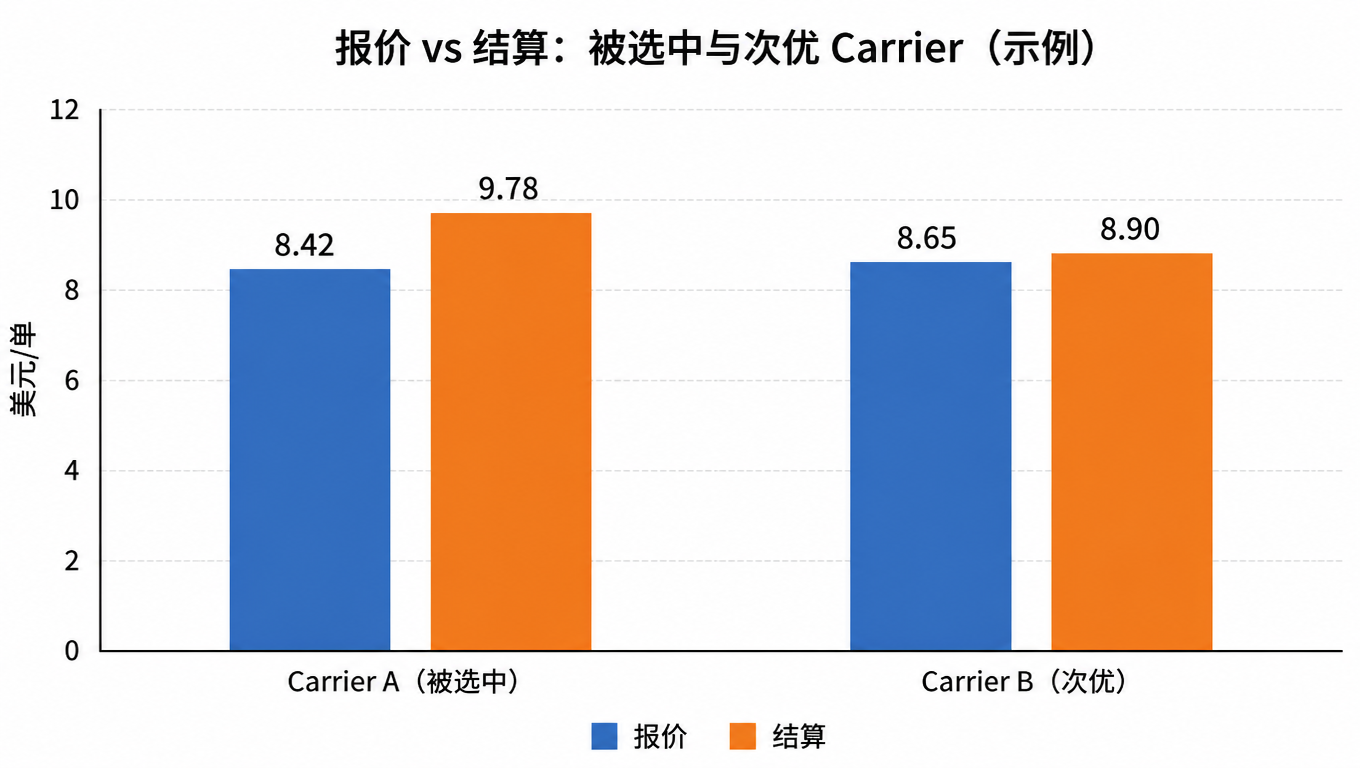
用一个简化例子说明第四步为什么重要(数字为演示用途):某条从洛杉矶仓发美东的 lane,30 天样本 1,200 单。系统选中的 Carrier A 在报价页面平均 $8.42,但结算账单平均 $9.78,差额来自 DIM 重量调整和 residential 附加费;次优的 Carrier B 报价平均 $8.65,结算平均 $8.90。只看报价,选 A 每单省 $0.23;看结算,选 A 每单多花 $0.88。这条 lane 一个月就多付出约 $1,056,而它当初看起来是「更便宜」的选择。

柱状图:报价 vs 结算,Carrier A 报价 8.42 结算 9.78,Carrier B 报价 8.65 结算 8.90,单位美元/单(示例)
被选中与次优 carrier 的报价 vs 结算(示例数据)

流程的价值在于,每一步都产出证据而不是结论。30 天周期结束,你会得到一份「哪些 lane 在亏、哪些规则在失效、哪些数据在漂移」的清单,而不是一句「规则好像还行」。账单侧的对账方法可以进一步看《物流对账指南》,也可以直接用我们的账单对账检查清单跑一遍。

用你自己的 margin、SLA 和风险容忍度定阈值

这篇文章不会给你一套统一的「正确阈值」,因为不存在。正确的阈值来自你自己的三个数字:margin 决定成本线,SLA 决定时效线,风险容忍度决定异常线。

手绘编辑插画:两个人在仓库一角摊开一张对账表,其中一人手指着表上的某一行数字,旁边放着一台打单机和几卷快递面单,墨线加橙色填充,线条带手作感,不追求完美对称
把阈值写下来、贴出来,作为规则的硬边界

margin 侧:把 carrier 的结算成本加总,看它吃掉了多少毛利,超过某个比例就该重新选。SLA 侧:on-time rate 低于你对客户的承诺,或者 promise 与实际送达的偏差超过容忍度,就该换 service 或换 carrier。风险容忍度侧:override rate 超过多少说明规则失去信任,异常单的 refund、claim 成本超过多少说明必须干预。这三个数字要写下来、贴出来,作为规则的硬边界,而不是凭感觉判断。

阈值还要固化进运营节奏:月度看结算与 override 的偏差,季度做一次完整复审,遇到重大费率调整或 carrier 线路变化时临时触发一次。审计不是一次性项目,而是持续运营能力。它存在的意义,是让自动化的每一单,都经得起「为什么选它」这一问。

想让自动选承运商的每一单都可解释?

EasyShippingX 的 Shipping API 在多承运商费率、面单和追踪之上提供统一的决策层:候选集按真实 serviceability 过滤、选择理由随单记录、结算成本可回对比报价。配合本文的 30 天审计流程,你可以在规则、数据和结算三个层面持续验证「为什么选它」。看看定价或约一次演示。

常见问题

自动选择遵循的是规则里写的优先级和约束:候选集、资格限制、费率比较和 fallback。它不会考虑你在报价页面上看不到的东西,比如结算附加费或某条 lane 的时效表现。这正是需要审计的原因:把系统做出选择时的输入和规则调出来,逐环核对,而不是凭感觉质疑结果。
有差距是常态,关键在于差距有多大、集中在哪。DIM 重量调整、residential 附加费、燃油附加费和地址更正都是报价之后才出现的费用。如果差距集中在某几类附加费或某几条 lane,说明规则在按报价而不是按结算成本做决策。
推荐 30 天一个周期,因为多数承运商的结算周期在这个量级,30 天足够把报价、结算、送达三个结果对齐。另外在重大费率调整或承运商线路变化时临时触发一次,季度做一次完整复审。
没有放之四海皆准的阈值,它取决于你的业务复杂度和风险容忍度。判断标准不是数字本身,而是趋势和分布:override 是否集中在同一类订单、同一个 reason code?是稳定上升还是偶发?先给 override 建标准 reason codes,再谈阈值。
先分清楚问题出在哪一环。同一类订单反复选错,通常是规则优先级或候选集配置问题;错误集中在某些重量段或 ZIP,通常是数据问题,比如 dimensions 或 serviceability 不准。一次只改一类,做小比例 controlled rollout,并保留回滚条件。
看三件事。第一,这次改选当时有没有记录原因码;没有记录,唯一诚实的动作是先把记录补上,而不是去指责规则。第二,原因属于哪一类:有效例外、输入错误、规则错误,还是执行条件变化。第三,看分布:如果改选集中在同一个客户、同一个仓库或同一个原因码上,原因就是系统性的;如果分散在很多不同原因上,通常只是业务本身的复杂度。对没有实际承运的备选方案,只能做估算或试点,不能把它的费用和交付表现当成已经发生的结果。