物流诊断

运费时效出问题,到底怪承运商、仓库还是软件?一套诊断框架

每一件物流异常的开头都一样:客户问包裹到哪了,你打开追踪页,包裹看起来卡住了,总得有个人背锅。多数团队跳过诊断,直接开骂。这篇文章给你一套两步框架,用已有的订单、仓库和承运商记录逐层定位根因;所需时间取决于记录完整度和调查权限。

三个嫌疑人分别是软件、仓库和承运商。软件层管订单周围的一切数字化环节:地址校验、费率、面单、追踪号、系统之间的数据交接。仓库层管交接之前的一切实体环节:拣货、打包、扫描、截单、库存。承运商层管交接之后的一切:取件、转运、派送、异常。几乎每一件物流问题,指纹都只落在其中一层,框架教你把它读出来。

你最终会拿到:一套在时间线上定位断点的方法、三份分层的自查清单、三个用于解释方法的假设诊断示例,以及让异常越来越少发生的监控习惯。

放大镜下的仓库传送带包裹,背景是配送路线图
诊断的第一原则:永远别猜,让时间戳说话

为什么物流问题总被误诊

物流问题被误诊的第一个原因是甩锅三角。客户看到包裹迟到,怪店铺;店铺看着追踪页显示包裹「已在承运商手里」,怪承运商;承运商查自己的扫描记录,看到取件来晚了或者面单生成错了,怪仓库或软件。每一方都有干净的数据证明自己这一步没问题,每一方都有把手指向外的动机,因为没人想让退款从自己的利润里出。

第二个原因是那套经典打法:退款、道歉、怪承运商、等下一个事故、再来一遍。退款保住了这一单的客户,但根因没动,下周同一个故障还会重演。这套打法永远修不好任何东西,因为它从不定位断点,只是为症状买单然后继续。

误诊的成本会快速复利。每一起事故都等于一笔退款,加上分摊在邮件、在线聊天和升级流程上的客服工时。一部分受影响的客户会留下差评,或者干脆流失。对一个月发几千单的品牌来说,2% 的迟到率就是每周几十起事故,每一起都要把同一个甩锅三角重新吵一遍。更糟的是,误诊会拖延真正的修复:一个软件改一行配置就能解决、一天就能修完的问题,会悄悄跑上好几个月。

这也是「干脆换承运商」经常失灵的原因。如果断点在软件层,比如一个会把追踪号弄坏的面单生成器,或者在仓库层,比如一个跳过扫描的打包团队,那么新承运商继承的是同一套坏输入。追踪页换了个颜色,问题一个没少。你只是换了箱子上的标签,没有修那台造标签的机器。
框架概览:两步,不靠猜

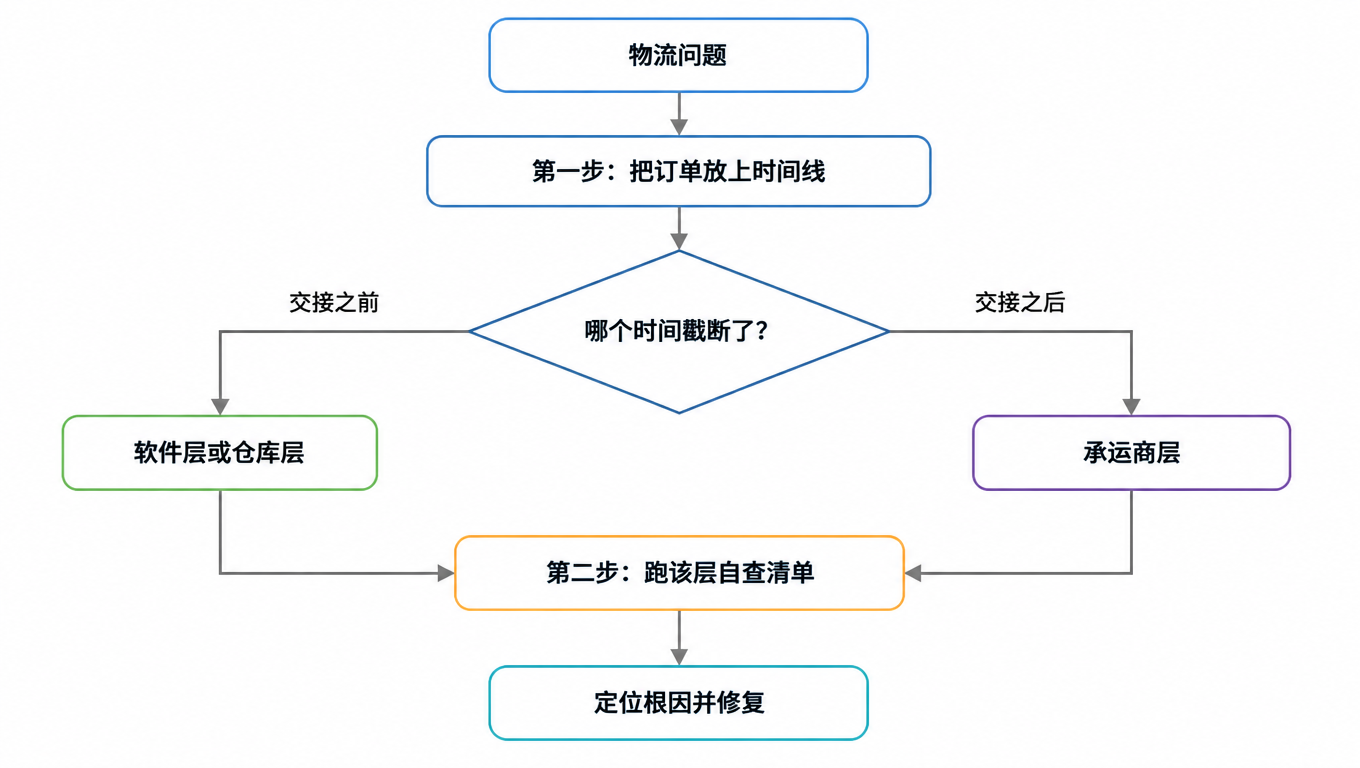
把物流问题当成网络工程师处理故障:先定位是哪一段,再修那一台设备。第一步把受影响的订单放上时间线、找到断掉的时间戳,把问题收窄到三层中的一层;第二步跑该层的自查清单,隔离出根因。两步,不靠猜。

三层很简单。软件层拥有所有数字环节:订单、地址校验、费率报价、面单、追踪号,以及系统之间的数据交接。仓库层拥有交接前的一切实体环节:拣货、打包、扫描纪律、截单处理、库存分配。承运商层拥有交接后的一切:取件、转运扫描、派送、异常。几乎每一件物流问题,指纹都只落在其中一层。

整个框架只有一条铁律:永远别猜。把你手上每一个数据源里这单订单的真实数据拉出来,OMS、WMS、承运商 API、公开追踪页,让时间戳指路。靠猜会把三十分钟的诊断变成一个月的小白鼠实验,而你的竞争对手的客户正在为这些实验买单。

两步框架流程图:物流问题放到时间线上,根据断掉的时间戳在交接前还是交接后,进入软件/仓库层或承运商层,再跑该层自查清单,最终定位根因并修复
断点在哪一层,决定你查哪一层

第一步:在时间线上定位断点

每一单订单都有六个有意义的时间戳:下单、打包、交接承运商、来件扫描、转运中、签收。每一个都有明确归属。「下单」属于软件。「打包」和「交接承运商」属于仓库。「来件扫描」「转运中」「签收」属于承运商。

健康的时间线是一串间隔小而可预测的时间戳。断掉的时间线会露出一个缺口:某个时间戳永远不出现,或者远晚于它该出现的时间。两条经验法则搞定大部分情况。第一,一个一直不出现的时间戳,指向本该产生它的那一方:没有来件扫描,说明承运商从没扫过这个包裹;没有交接扫描,说明仓库从没记录这次交接。第二,一个姗姗来迟的时间戳,指向负责它前面那一段的人:如果交接到来件扫描正常要四个小时、这次用了二十六个小时,那承运商的取件和前端网络处理就是嫌疑段。

数据从哪来?OMS 给你下单和出单时间戳,WMS 给你打包和交接扫描,承运商 API 和公开追踪页给你取件、转运和派送事件。关键动作是拿同一单订单跨数据源对比,因为不一致就是指纹。如果承运商 API 显示包裹已被物理签收,而 WMS 说它从没被打包,你已经找到那一层了。

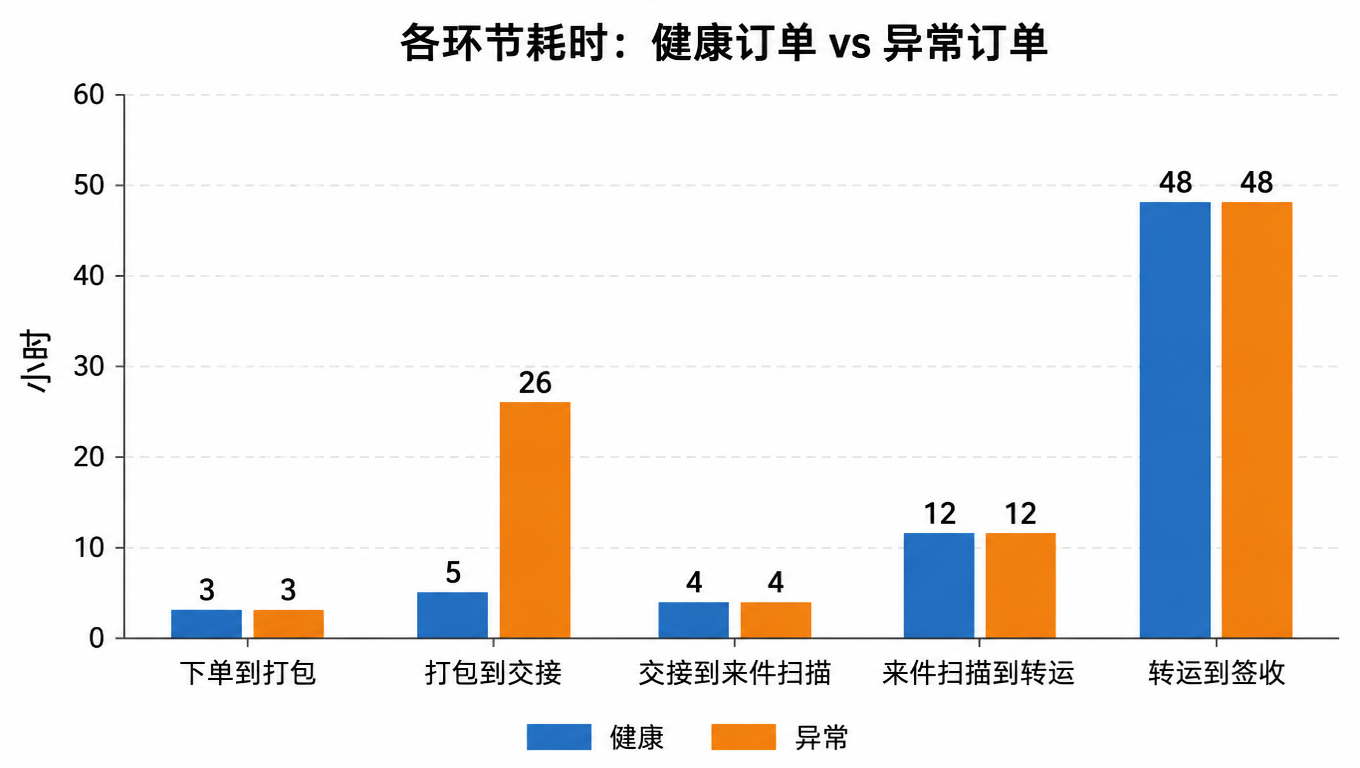
这是一条典型两日线路的健康基线:下单到打包 3 小时,打包到交接 5 小时,交接到来件扫描 4 小时,来件扫描到转运 12 小时,转运到签收 48 小时。现在拿同一线路的一单异常订单对比:下单到打包还是 3 小时,但打包到交接用了 26 小时而不是 5 小时。断点坐在仓库和承运商之间,还没读任何一个异常代码,嫌疑池就已经收窄到两层了。

各环节耗时对比柱状图:健康订单与异常订单,异常订单在打包到交接环节从 5 小时拉到 26 小时,其余环节一致
同一条线路,只有一段被拉长,断点就在那一段

一个提醒:永远不要拿一单下结论。拉十到二十单受影响的订单,看同一个断点是不是反复出现。孤立的一单是噪音,反复出现的模式才是 bug。如果缺口在样本里大多数订单的同一个时间戳出现,那个时间戳就是你的断点。

第二步:隔离软件层

软件层管结账时的地址校验、费率报价、面单生成、追踪号分配与到承运商 API 的同步,以及告诉仓库该打包什么的 webhook。软件故障是最阴险的一类,因为包裹本身没问题,是包裹周围的数据错了。

常见故障在不同品牌间反复重演。过期的费率表打出的面单,价格和报价、账单都对不上。用错时区算的截单时间,把订单整批晚一天入批,而仓库其实按时打包了。面单重生成循环造出重复面单,其中一张被取消,追踪号直接作废。webhook 静默失败,仓库根本不知道有这单,包裹一直躺到客户来问。追踪号没同步到承运商 API,你的系统里有这张面单,承运商那边毫无记录。

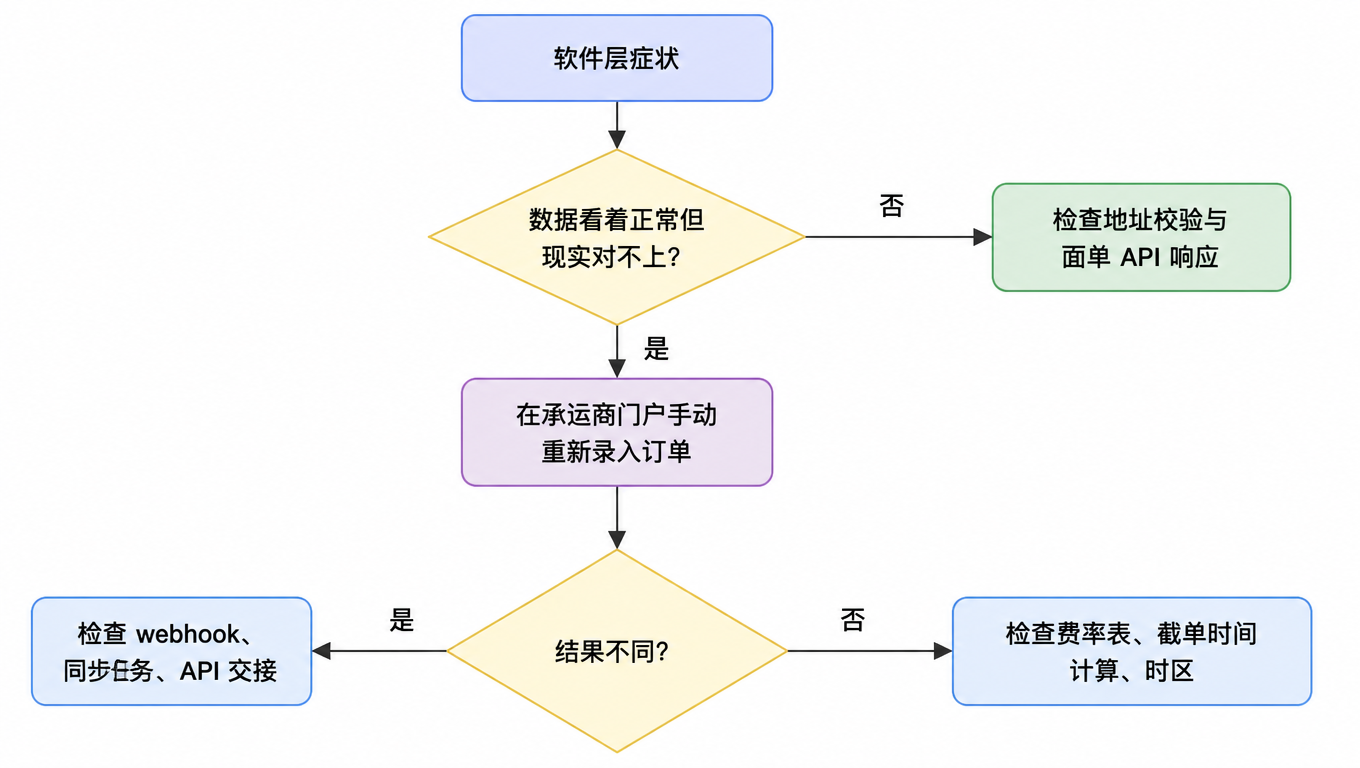
怎么判断是软件?两个信号。第一,数据看着正常但现实对不上:订单、面单、费率在你的后台里一切正常,承运商却查无此件。第二,同一单订单手动重录一遍,表现不一样。如果你把订单手打进承运商门户一切正常,软件层就是嫌疑人,因为你刚刚绕过了它。

断点落在交接之前的订单,跑这份清单:

  • 把面单上的费率对当前的费率表和最终账单。对不上,指向费率表过期。
  • 拿一单受影响的订单,在承运商门户里手动重录一遍。表现不同,说明你的软件管线有问题。
  • 把面单生成时间戳对配置的截单时间,注意用仓库时区换算,不是总部时区。
  • 在承运商门户里按参考号查这单,确认追踪号真的到了承运商 API。
  • 查 webhook 和同步日志,看受影响订单前后有没有静默失败。
软件层决策树:数据异常但现实正常时手动重录订单,结果不同则查 webhook 与同步,结果相同则查费率表、截单与时区,数据正常则查地址校验与面单 API
手动重录是软件层最便宜的探针

第二步:隔离仓库层

仓库层管拣货、打包、扫描纪律、截单处理、库存分配和多仓路由。仓库故障通常伪装成承运商故障,因为客户只看到包裹迟到、追踪变黑,从来看不到打包线。这正是这一层被误诊最多的地方。

常见故障一旦知道就很好认。漏扫打断追踪链:包裹正常在走,但系统从没记录交接,承运商 API 上露出一个看起来像承运商责任的缺口。截单后打包的批次赶不上当天的取件,平白多出一整天的时效。分配 bug 把订单路由到没有库存的仓,多出一段谁都没预算的调拨运输。旺季人手缺口拉长打包 SLA,却没有任何一个单独可见的错误。

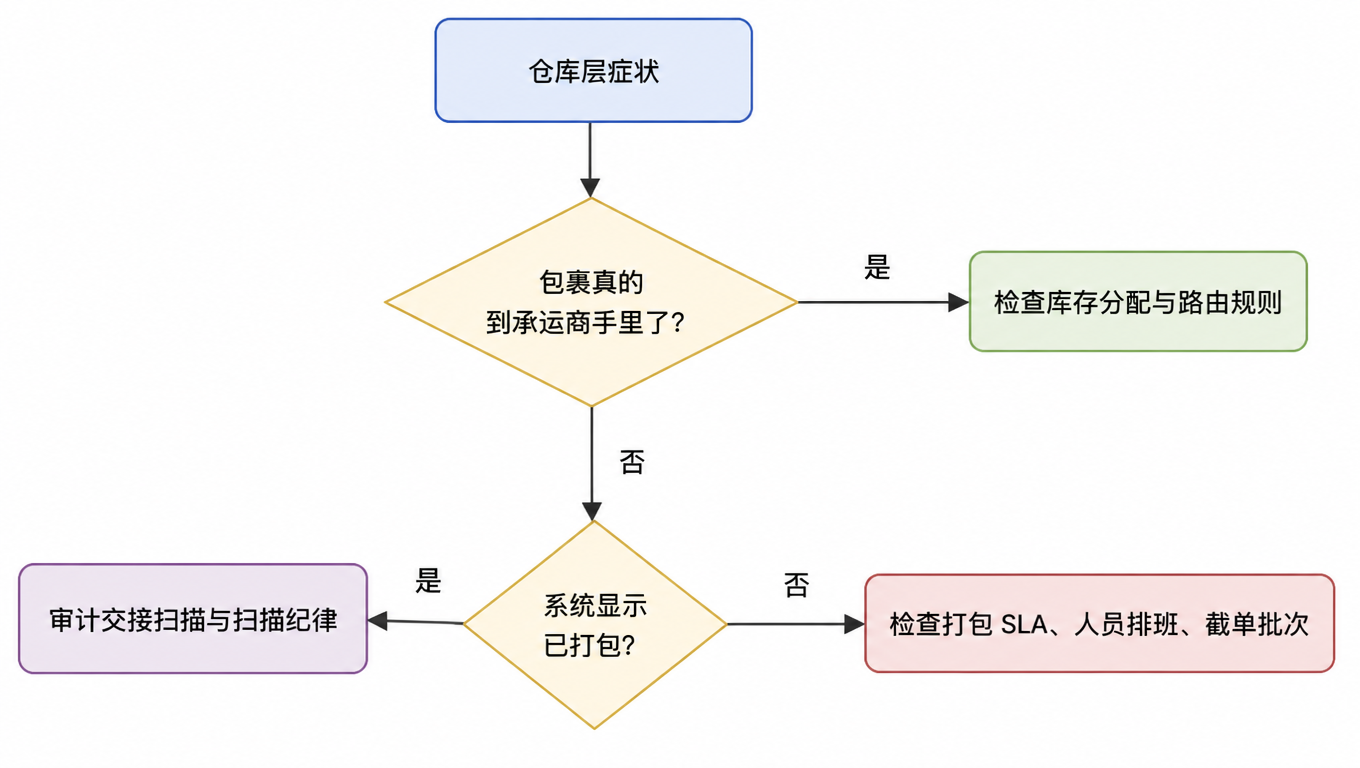
怎么判断是仓库?物理现实和系统互相矛盾。承运商 API 显示包裹已被始发枢纽签收,WMS 却显示它从没被打包,这个矛盾只可能来自仓库层。第二,故障成簇:同一个断点在同一个班次、同一个打包工位、同一批条码上反复出现。成簇是流程问题,不是运气差。

断点落在交接或交接之前的订单,跑这份清单:

  • 每一单受影响的订单都有打包时间戳吗?拉当班次的扫描率报告。
  • 交接扫描是否在打包时间戳之后、你的 SLA 之内?健康间隔是几个小时。
  • 订单分配到的仓库,真的有这批库存吗?查分配规则和库位数据。
  • 这批货赶上取件了吗?把批次关闭时间对承运商的实际取件时间。
  • 故障是不是围绕同一个班次、工位或面单批次成簇?成簇告诉你先查哪里。
仓库层决策树:包裹没到承运商手里时,系统显示已打包则审计交接扫描,未打包则查打包 SLA 与排班;包裹到了承运商手里则查库存分配与路由规则
物理现实和系统矛盾,就是仓库层的指纹

第二步:隔离承运商层

承运商层管取件安排、服务等级与承诺时效的匹配、网络事件、派送异常、破损和丢件。它是最后一个该被怪罪的,却总是第一个被怪罪,所以必须用数据证明,而不是用假设定罪。

常见故障是客服团队早就烂熟于心的那些。取件被跳过或迟到,悄悄多出一天时效。服务降级,两日承诺的货走了地面。天气和网络中断拖垮整个区域。误扫把包裹送到错误的目的地枢纽。派送到错误地址,还附上一张无比自信的错误门廊派送照片。

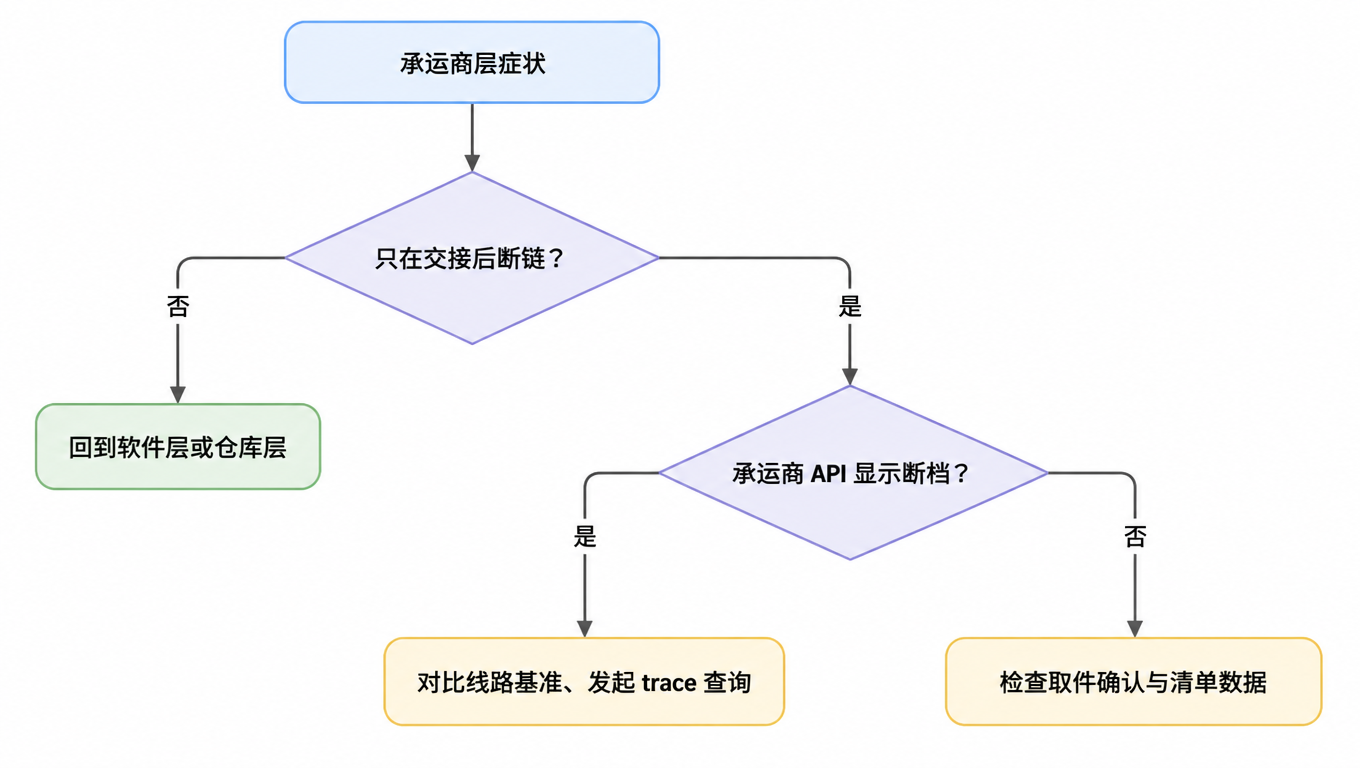
怎么判断是承运商?时间线只在交接之后断,而且承运商自己的 API 显示了这个缺口。包裹有了来件扫描,然后三十小时没有任何动静,而你的仓库时间戳全部健康,这一段就是承运商的。第二个交叉验证是跨承运商对比:拿同一条线路用第二家承运商跑一个月。如果两家都慢,问题在线路本身或者你买的服务等级,而不是某一家承运商。

承运商开放的数据通常够用:取件确认、扫描事件流、异常代码、派送照片。打电话之前,把受影响订单的这些数据全部拉出来,和你的时间戳排在一起。

断点落在交接之后的订单,跑这份清单:

  • 受影响的批次有取件确认吗?没有,或者来晚了,指向取件流程。
  • 追踪链断在哪?承运商 API 在这个点之后还有没有扫描?
  • 异常代码说了什么?天气、地址问题、清关扣留、派送异常,各自的归属方不同。
  • 面单上打印的服务等级,是客户被承诺的那个吗?降级是面单问题,不是网络问题。
  • 这家承运商在这条线路上最近一个月的准时表现,和第二家比怎么样?
承运商层决策树:只在交接后断链时,承运商 API 显示断档则对比线路基准并发起 trace,无断档则查取件确认与清单数据;交接前就断链则回到软件层或仓库层
承运商要有罪,先让它的 API 作证

三个真实诊断案例

以下企业画像、时间、百分比和结果仅为教学假设;不代表 EasyShippingX 客户记录,也不证明每次异常都能在同样时间内解决。

看着框架跑起来,你会更容易信任它。下面三个案例做了匿名化处理,但都是真的,而且每一个都遵循同样的形状:症状、时间线、定位层、根因、修复、教训。

假设示例 1:看起来像承运商责任的延误。一个 DTC 品牌的准时率三周内从 96% 掉到 81%。时间线显示打包时间戳全部在 SLA 内,但打包到交接从 5 小时拉长到 26 小时。定位层是软件,因为断点坐在打包扫描和清单之间。根因是一个截单 bug:发货软件的截单字段配置为下午 4 点,却按 UTC 存储和比较。对太平洋时区的仓库来说,UTC 下午 4 点落在本地上午,具体偏移取决于日期与夏令时,所以上午过半之后每一单都被划进「明天的批次」,等一整天才有面单。修复是一行时区修正,一周内准时率恢复。教训:截单计算属于软件层,而一个时区 bug 穿着承运商的制服。

假设示例 2:取件后追踪变黑。一个卖家的追踪显示「已取件」,然后 36 小时毫无动静,直到一条签收扫描出现。时间线显示来件扫描在、签收扫描在,中间唯独没有交接扫描。定位层是仓库。根因:品牌换了一批新面单,条码格式 WMS 扫描枪读不出来,交接扫描被静默跳过。承运商始终没对上清单,枢纽一天半之后才手工重处理这批货。修复是升级扫描枪固件、一次性补扫,并给任何扫描率下降加告警。教训:交接扫描是仓库和承运商之间的数据契约。它断了,追踪就变黑,哪怕承运商完全无辜。

假设示例 3:运费账单跳涨 22%。一个品牌看到月度运费账单飙升,费率却没变。这里的时间线不讲延误,讲重量:整条新产品线,面单重量和计费重量差了 1.8 倍。定位层是仓库,在打包工位。根因:新产品更轻,打包团队却继续用旧的大箱子,承运商在枢纽用体积测量仪重测了体积重。面单带着实际重量,账单带着体积重。修复是换合适的箱子、修正面单尺寸,并加一份每周面单对账单重量差异报告。教训:成本问题藏在尺寸数据里,不在费率表里,而一份差异报告能在账单惊吓之前几周就抓住它。

从诊断到预防:建立监控习惯

只在事故发生时拿出来用的框架,是一支灭火器。最后一步是把它变成习惯,让事故本身变少。

先建一张每周 SLA 看板。盯三个数:准时率、追踪断档率(超过 24 小时没有扫描的订单占比)、异常率,每一个都按层拆解。每周三十分钟,把事故变成趋势,而趋势会在事故到来之前告诉你下一个事故会从哪来。

设好在客户投诉之前就响的告警:到计划取件时间没有取件确认、24 小时没有扫描、高价值订单出现派送异常。先告警,再退款。大多数客户只是想让你知道你已经注意到了,一条主动的消息胜过一张退款回执。

在看板旁边放审计日志和变更控制,因为上个月修好的问题会悄悄复发。有人回滚了一个配置、一个供应商更新了 API、仓库经理改了排班,你修好的指标又爬回去了。当某个数字回退时,先 diff 变更记录;回退通常是你自己已经做过的某个改动。

在需要之前就摸清升级路径。承运商问题,在承运商的申诉窗口内开案,附上你的时间线证据,窗口关得很快。软件问题,用手动重录测试复现 bug,把准确的订单和时间戳交给供应商。仓库问题,带着扫描率报告找你的 3PL 客户经理,如果纪律没有改善,重新谈 SLA 或者迁移货量。

最后,给仓库运营者的镜像视角。当你成为被指控的一方,把同一套框架倒过来跑:拉你的扫描日志和交接时间戳,精确展示你的流程在哪里结束、承运商的流程从哪里开始。用数据辩护:准时打包率、扫描率、清单匹配率。框架双向可用,最后拍板的是数据,不是嗓门最大的人。

下次订单延误,别问是哪家承运商,问是哪个时间戳。时间戳指向层,层指向修复。

常见问题

把订单放上时间线。六个时间戳(下单、打包、交接承运商、来件扫描、转运中、签收)各有归属:一个一直不出现的时间戳,指向本该产生它的那一方;一个姗姗来迟的时间戳,指向两个时间戳之间负责的那一段。然后再跑那一层的自查清单。断点是指纹,不是观点。
因为断点可能根本不在承运商。如果面单生成器弄坏了追踪号,或者打包团队漏扫,新承运商继承的是同一套坏输入。先跑时间线方法:如果断掉的时间戳在交接之前,修复在你的软件或仓库里,换承运商没用。
不一定。追踪断档有三个常见归属:仓库漏扫交接(包裹正常在走,但系统没记录交接)、软件同步静默失败(追踪号根本没到承运商 API)、或者承运商网络真的断档。下结论之前,交叉核对 WMS 扫描日志、承运商 API 和你的面单时间戳。
拉十到二十单受影响的订单,绝不要只看一单。一个孤立异常是噪音,反复出现的模式才是 bug。如果同一缺口在样本里大多数订单的同一个时间戳出现,那个时间戳就是断点,修复方向随之变得明显。
事件诊断是被动的,监控才是习惯。每周跑一次 SLA 看板:准时率、追踪断档率、异常率,按层拆解;再设好抢在客户投诉之前的告警:到取件时间没有取件确认、24 小时没有扫描、高价值订单出现派送异常。每周三十分钟,把事故变成趋势。
技术上可能,但诊断时不要把“系统允许生成事件”和“操作符合规则”混为一谈。免签包裹投放到获准位置后即可扫描,不需要当面交给收件人;若扫描早于实际投放,或地理位置不在目的地,就是提前或错误扫描。USPS 要求在实际送达点完成终止计时扫描,USPS 监察长办公室也记录过在投递局内生成的错误送达扫描。先排除时区显示、通知延迟和家人代收,再调取原始事件类型、设备时间、扫描坐标、照片或签名以及派送路线记录。公开追踪页的一行“已送达”只是线索,不是完整交接证据。
因为清单关闭、批量接受和单件实物交接是不同事件。发货系统完成日结或上传电子清单后,标签可以进入“已生成清单”状态;以 USPS 为例,一张批量交接表单的主条码可关联多票标签,扫描主条码会为每个关联标签生成接受事件,具体机制见 USPS 批量交接表单说明。如果纸箱漏装、仍在打包台,或者标签被错误纳入清单,它就可能有批量事件,却没有完成实物交接。按四层日志核对:清单版本及标签列表、仓库最后一次单件扫描、笼车或拖车装载与取件交接记录、承运商后续单件来件或处理中心扫描。最后一项通常才是实物进入网络的强证据。
建立一条同时包含承运商事件和现场事件的分钟级时间线。扫描坐标在投递局或错误地址、照片不是本门牌、签名不符,而且门铃录像在扫描前后连续显示司机从未到达,支持“虚假扫描或错投”。照片与地址和包裹相符、扫描时间地点合理,门铃或门禁先记录司机投放、之后又记录另一人拿走,才支持“送达后失窃”。照片、签名、坐标都不是单独定案的证据;还要核对通知延迟、设备时区、共用收发室和家庭成员代收。缺少投放或拿走的关键证据时,把根因标为“未能确定”,继续调查,不要为了结案硬分责任。