电商物流指南

电商发货容量规划:订单量翻倍时,最先崩的是哪一环?

订单量翻倍是电商团队最想遇到的「问题」。但真正经历过的人都清楚:增长不会均匀地铺到每一天,也不会均匀地压到每一个环节。它常常在某个周五下午,以「cutoff 前还有几百单没打完」的形式突然出现。这篇指南讲清楚两件事:订单翻倍时,发货链条上哪一个环节会最先崩;以及如何在崩之前,用一套压力测试把它找出来。

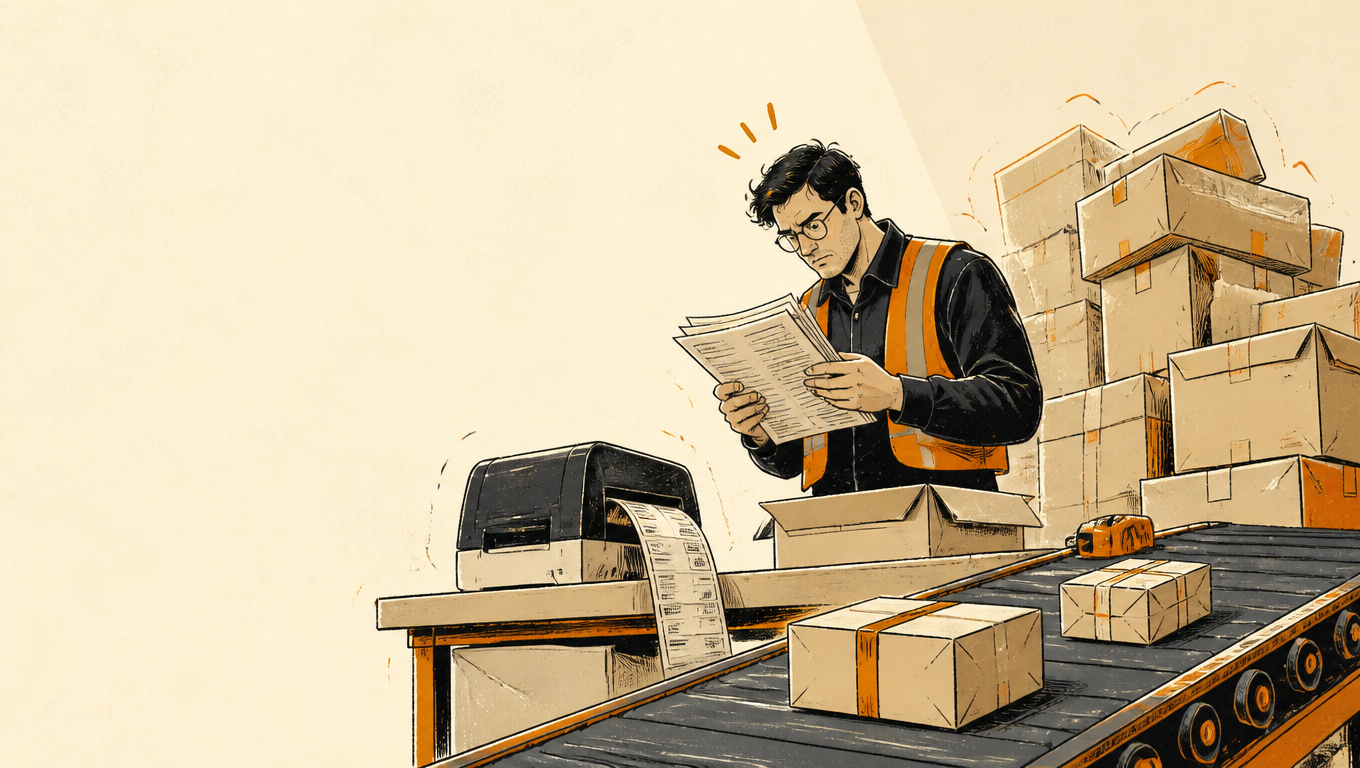
编辑插画:发货主管站在打包台与面单打印机之间低头查看手里一沓面单,身后纸箱堆得歪斜、传送带上还有两个待发包裹,近景略带仰角,米白底色配暖橙色点缀,线稿有轻微抖动和纸纹颗粒感,构图左侧留白,带一点松弛的幽默
增长不会均匀地压到每一个环节,它只会压到链条上最弱的一环。

症状:订单翻倍前,团队先看到这些红灯

增长是好事,直到发货开始跟不上。最直接的信号是下午 cutoff 之前订单清不完,加班成为常态,然后你会发现「每天需要更多人处理同样的发货工作」。这通常不是态度问题,是流程里某个环节已经悄悄到顶了。

更隐蔽的信号藏在系统里:rate comparison 和 label creation 开始排队,查一次费率要转圈好几秒;inventory、order、tracking 三个系统的状态互相对不上,同一个订单在不同页面显示不同进度;primary carrier 的 pickup 窗口装不下全部包裹,被迫每天分两批交运,还总担心第二批赶不上扫描。
编辑插画:傍晚仓库一角,两三名工作人员围在打印机和打包台前匆忙作业,墙上挂钟指针指向下班时间,纸箱堆得不整齐,线稿略有抖动、橙色填色溢出边缘一点点,米白与暖橙主色调,视角从门口向内望,留白充足
订单集中在最后两小时,压力全压在下班前的仓里。

再往下看,exceptions、WISMO[1](where is my order,客户来问「我的货呢」)咨询和 reconciliation(对账)工作的增长速度,比订单本身还快。平均日单量看起来还扛得住,但一到促销日(Prime Day、黑五这类),立刻崩,旺季发货量可以冲到平时的 3 到 5 倍[2]。

这时候团队最常见的结论是「容量不够」。但没人说得清:是仓库不够、人不够、打印机不够、承运商不够,还是系统不够?本文把这个问题拆成一条 Shipping Capacity Chain,再给出一套 Double-Volume Stress Test,让你在订单真正翻倍之前,先知道哪一个环节会最先崩。
为什么「每天能发多少单」骗了你

传统 capacity planning 的衡量方式是「我们每天能发多少单」。这个数字本身没错,但它是日均值,而容量问题几乎总是发生在峰值时刻,容量应该按峰值评估,而不是按日均量[3]。日均订单量会系统地隐藏下面这些变量:

  • 订单是否集中在最后两小时(peak-to-average ratio,峰值与均值的比值);
  • lines per order 和 split shipments(一个订单几行货、是否分批发货);
  • 对接了多少个 marketplace,每个平台的规则数量不同;
  • 包裹尺寸和 service complexity(大件、多件、国际件);
  • manual override 和 rework(人工改单和返工)占多少比例;
  • carrier pickup cutoff(承运商当日揽收截止时间);
  • API latency 和失败重试(重试会不会打重复面单);
  • returns、exception、billing 的后置工作量有多大。

这些变量没有一个是「每天能发多少单」能反映的。举一个示例:日均 300 单的系统,可能 80% 的订单集中在下午两小时,那一瞬间的实际吞吐需求是平均值的四五倍。

所以「增加人手」往往解决不了问题,原因有四:数据问题不会被更多员工修复,状态对不上,加十个人也还是对不上;carrier capacity 不会因为仓库多一个人而增加,UPS 下午 4 点来揽收,错过时间窗口当天就只能靠补收一次,不会因为你在加班就多等两小时[4];错误规则只会被执行得更快,SOP 是错的,加人只会更快地做错;软件和 API bottleneck 依然存在,打单系统一秒只能出三张面单,人再多也得排队。

结论:容量不是一个数字,是一条链。整条链的实际容量不等于各环节的平均值,而取决于最弱的一环,这正是约束理论(Theory of Constraints)的核心观点:系统的吞吐由瓶颈环节决定,而不是由表现最好的环节决定[5]。

Shipping Capacity Chain:七环链条

把从「订单进来」到「账单结清」的整个流程切成七环,每一环都可能成为瓶颈:

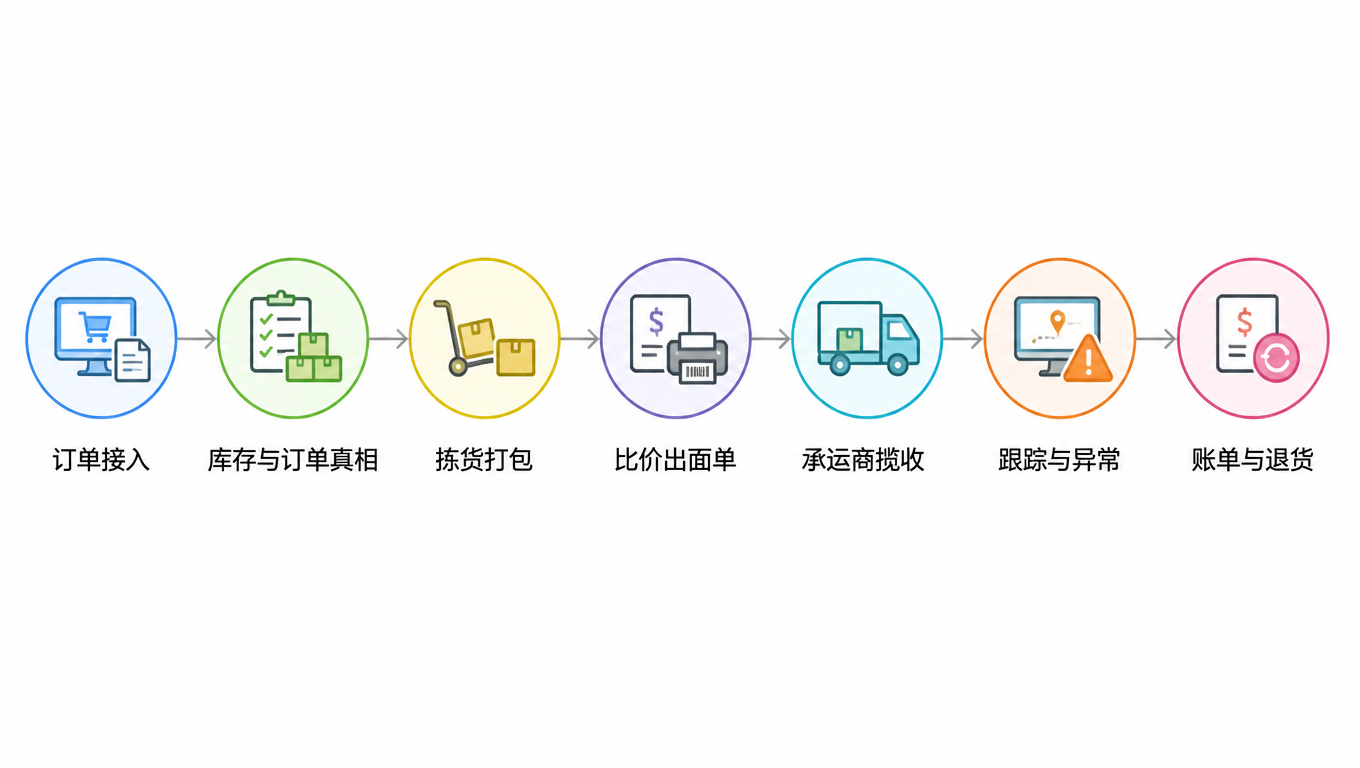
流程图:订单接入、库存与订单真相、拣货打包、比价出面单、承运商揽收、跟踪与异常、账单与退货,七环依次相连
七环链条:容量取决于最弱的一环。

每一环的职责和典型瓶颈信号:

  • 订单接入(Demand Intake):从各 marketplace 和 channel 同步订单。瓶颈信号:订单同步延迟、重复订单、字段缺失导致下游报错。
  • 库存与订单真相(Inventory & Order Truth):库存、订单、可发状态的单一事实来源。瓶颈信号:超卖、状态不一致、人工改单。
  • 拣货打包(Pick & Pack):拣货、打包、称重、贴单的人力作业。瓶颈信号:队列变长、mispick 率上升、加班时间增加。
  • 比价出面单(Rate & Label):比价、选服务、生成面单。瓶颈信号:查询排队、打单变慢、manual override 比例升高。
  • 承运商揽收(Carrier Induction):揽收交接、集货、交给承运商。瓶颈信号:错过 pickup cutoff、当日揽收量被限、被迫拆分交运。这一环的容量投资直接决定末端成本与体验,可参考我们关于最后一公里真实成本的指南。
  • 跟踪与异常(Tracking & Exceptions):扫描、追踪、异常处理、WISMO。瓶颈信号:exception 数量激增、客户咨询变多、客服排队。
  • 账单与退货(Billing & Returns):账单核对、退件、退款、reconciliation。瓶颈信号:对账积压、billing adjustment 变多、退款处理变慢。

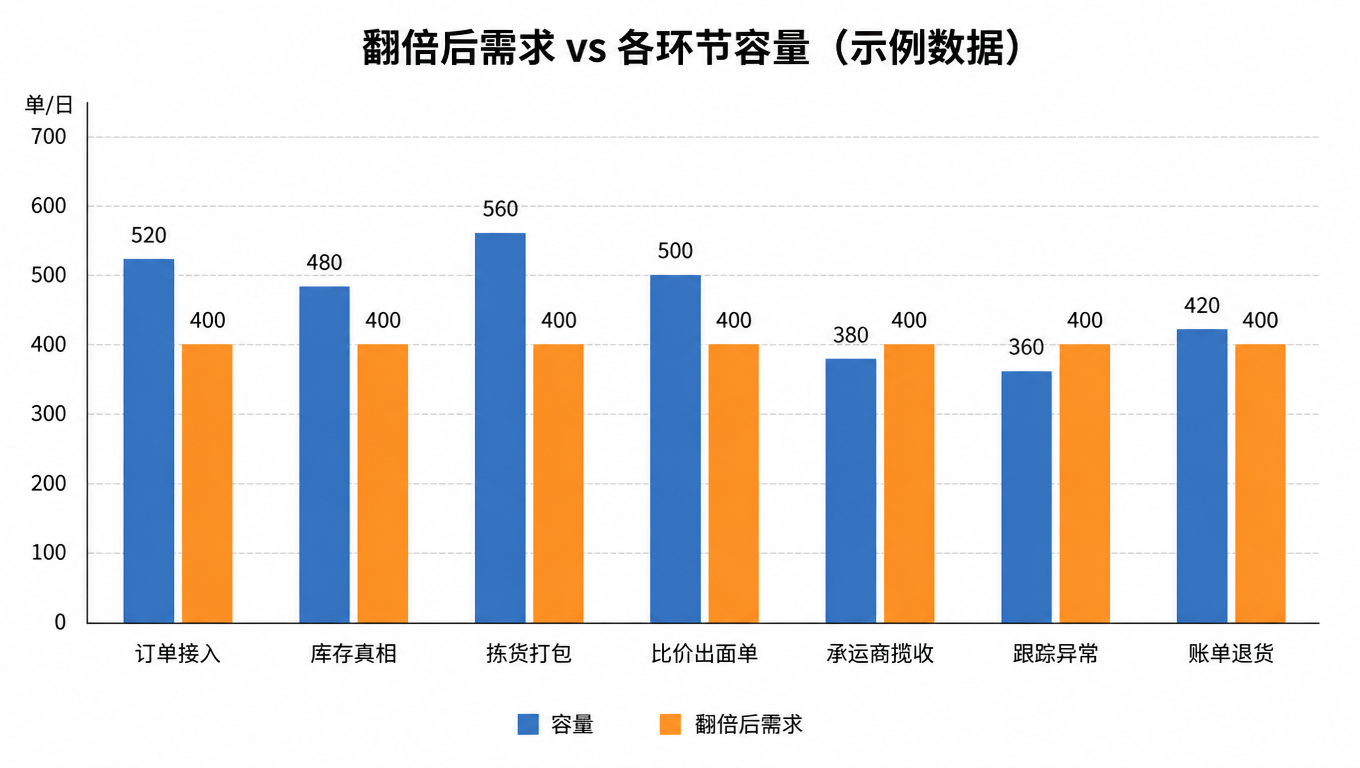
核心原则:不要升级最显眼的环节,要升级真正限制总体吞吐的环节。举一个示例:假设翻倍后日均需求是 400 单,各环节容量分别为订单接入 520、库存与订单真相 480、拣货打包 560、比价出面单 500、承运商揽收 380、跟踪与异常 360、账单与退货 420:

柱状图:翻倍后需求(400 单/日)对比各环节容量,承运商揽收 380 与跟踪异常 360 低于需求线,拣货打包 560 最高
翻倍后需求 vs 各环节容量(示例数据)

这个例子里,拣货打包看起来最忙(容量最大、最显眼),但它不是瓶颈。真正的瓶颈是承运商揽收(380)和跟踪与异常(360),它们低于 400 的需求线。此时去给打包台加人、加一张桌子,是在升级最显眼的环节;正确做法是去谈第二个承运商、把异常处理自动化。注意:这里的数字只是演示方法的示例,真实阈值必须用你自己的 baseline、SLA 和利润要求来定,不要套用任何行业统一门槛。

关键变量:把容量拆成五组可测量的量

瓶颈信号是定性判断,落地到方案之前,先把容量拆成可测量的变量。我们分成五组:

组 关键变量 为什么影响容量
订单负载average orders/day、peak orders/hour、peak-to-average ratio、marketplace/channel mix、lines per order、split shipment rate决定需求曲线的形状,峰值比值越高,越考验短时吞吐
仓库执行labor minutes per order、pick/pack queue length、rework and mispick rate、missed cutoff rate、backlog age决定人力成本随订单增长的斜率
发货技术manual rate decisions per order、label creation throughput、API latency/error rate、retry and duplicate-label behavior、manual override rate、batch processing capacity决定自动化系统能扛住多少倍增长
承运商运力pickup cutoff、daily acceptance/capacity limits、active carrier count、ZIP/service coverage、package and zone mix、fallback readiness决定物理上能运走多少包裹
下游工作tracking exceptions、WISMO contacts、RTS/reship/refund、billing adjustment volume、reconciliation time per shipment决定后台人力会不会跟着订单一起爆炸

把这五组变量放进一个每周追踪的表,把每一环的容量和需求画成上一节那样的对比图,容量规划就从「感觉」变成了「测量」。注意每组的第一个动作是给每个变量定一个你自己的正常区间和警戒线,这比任何行业基准都可靠。

Double-Volume Stress Test:找到最先崩的环节

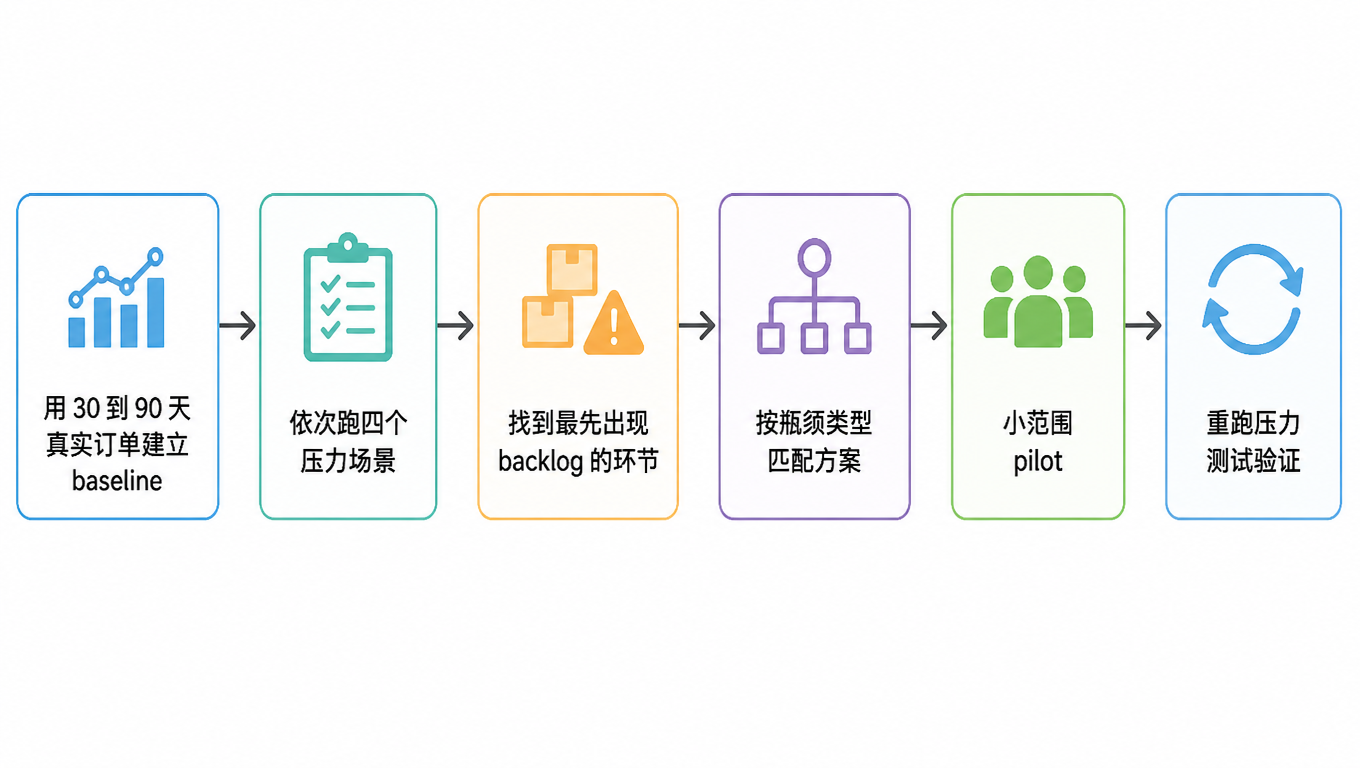
方法很直接:用你自己过去 30 到 90 天的真实订单建立 baseline,然后模拟四个场景。为什么要用真实订单?因为只有真实数据才包含你特有的渠道组合、包裹结构和时点分布,任何编造的数字都会给出错误答案。

四个场景:

  • 场景 1,正常翻倍:把 baseline 的日均量乘以 2,逐环节过一遍,看哪里先积压。
  • 场景 2,短时窗口集中:把翻倍后的量压缩进最忙的两三小时,模拟促销日。
  • 场景 3,primary carrier 不可用:假设主力承运商当天停摆,看备用方案能不能接住。
  • 场景 4,某技术层性能下降:假设 shipping/WMS/API 某一层变慢或失败率升高,看重试和排队会不会拖垮整条链。

每个场景的目标只有一个:找出最先出现 backlog 的环节。找到之后,按瓶颈类型选方案:

  • 劳动力瓶颈:优化布局、SOP、班次或招聘;
  • 决策/面单瓶颈:批量流程、Portal、Excel 或 API。自动化比价的回本判断,可以对照我们的自动化比价回本指南;
  • Carrier 瓶颈:multi-carrier、regional options、capacity plan。想系统性地加第二家承运商,从我们的多承运商策略指南开始,再对照区域承运商何时更省钱和承运商冗余设计;
  • 数据瓶颈:明确 source of truth、修复 integration;
  • 设施瓶颈:3PL、multi-warehouse 或新仓;
  • 异常瓶颈:exception automation 和明确的责任分工。
流程图:用 30 到 90 天真实订单建立 baseline,依次跑四个压力场景,找到最先出现 backlog 的环节,按瓶颈类型匹配方案,小范围 pilot,重跑压力测试验证
压力测试循环:找出瓶颈,对症下药,小范围验证,再重跑。

最后一步:先做小范围 pilot,确认方案真的把那个环节的容量提上去了,再重跑压力测试。容量规划不是一次性项目,而是每个季度、每次增长预期变化时都要重跑一遍的循环。所有阈值都用企业自己的 baseline、SLA 和利润要求来定,本文不给统一门槛,因为统一门槛就是错的。

小结:容量是链条问题,不是日均数字问题

订单翻倍不会均匀地压到每一个环节,它只会压到链条上最弱的那一环。日均订单量是平均数,容量问题是峰值问题,更是链条问题。加人、换承运商、升级软件,任何单一动作都不一定能解决问题,先找到最先崩的环节,再决定把力气花在哪。

如果今晚就想开始:用你自己过去 90 天的数据跑一遍四个压力场景,找出第一个出现 backlog 的环节;按瓶颈类型选一个方案,小范围 pilot;把五组变量放进每周追踪。工具层面,比价、批量打单、多承运商切换和异常提醒这类环节,正是自动化系统该替你扛的部分,把人力留给真正需要判断的事。

想在订单翻倍之前,先知道哪一环会崩?

EasyShippingX 提供多承运商实时比价、批量打单、面单与追踪,比价和出签环节可以批量跑、自动选承运商,路由规则里可以预设备选,峰值时多承运商并行,异常与追踪提醒自动分流。这样 Decision/面单和 Carrier 这两类最常见瓶颈,就不用靠人肉扛。看看定价或约一次演示。

常见问题

没有普适答案,但最常见的两个是承运商揽收和跟踪异常:一个受物理运力和 pickup cutoff 限制,一个跟着订单量一起涨、还叠加上游积压的放大效应。要确认你自己的瓶颈,用 30 到 90 天真实订单跑一遍四个压力场景,看哪个环节先出现 backlog。
因为日均值会隐藏时点集中。80% 的订单挤进最忙的两三个小时时,那一瞬间的吞吐需求可能是日均值的四五倍,任何按日均量配置的环节都会在那一刻到顶。容量按峰值评估,不按日均评估。
四种情况加人无效:数据状态对不上,加人也不会对得上;承运商运力不会因为仓库多一个人而增加;错误规则只会被执行得更快;软件和 API 的吞吐上限不变,人再多也要排队。先分清瓶颈是劳动力、决策、承运商、数据、设施还是异常,再决定加不加人。
每个季度一次,外加每次增长预期、承运商结构或渠道组合变化时补跑一次。每次跑完先小范围 pilot 验证,再重跑压力测试确认瓶颈真的移走了。容量规划是循环,不是一次性项目。